
昨晚我是带着一副糟糕的状态睡着的。
心里压着对未来的沉重思绪,头痛欲裂,牙也疼。我不知道新的一天会带来什么。我只是期待奇迹,做了祷告,然后睡去。
结果到了早晨,奇迹真的发生了。
头痛和牙痛像变魔术一样消失了。为此,我要深深感谢我的妻子 Victoria,以及我的牙医 Alina——感谢她那双灵巧的手、她的细心,以及她对我健康的真诚关心。
但这个早晨还给了我另一个奇迹。规模完全不同的奇迹。
Cubrim 终于登上了世界数据压缩基准的榜首。
对我来说,这不只是一条技术新闻。这是一个始于许多年前的故事。
一个从学生时代就抓住我的想法
还在做学生的时候,我就痴迷于这样一个想法:我能解决一个基础的、实用的算法问题——数据压缩问题。
应用算法中有几个可以称为基本支柱的方向:搜索数据、排序数据和压缩数据。
搜索和排序,当时在我看来太庞大、太成熟,离我感到自己能发力的地方太远。而压缩则让我着了迷。我总觉得,人类还没有完全探索过这个领域。在现有算法之外的某个地方,还存在着别的方法。更强大、更优美、更通用。
我日夜都在想它。
有时我会在半夜醒来,带着又一个“绝妙”的主意,赶紧记下来,然后一旦尝试在电脑上实现,就发现我是在重新发明轮子。或者干脆想出了一个糟糕的算法。又或者是那种在脑子里听起来很美、一接触真实数据就土崩瓦解的主意。
但我一直在坚持。
经过许多个月这样的实验,我得到了一些自己再也无法完全理清的想法。我老实说:那非常困难。是的,我有数学背景,但就连那也不够。而且那时既没有计算资源,也没有工具,更没有能在合理时间内检验我的假设的帮手。
于是我把这些想法搁置起来,“留待以后”。
岁月流逝。
而那个“以后”终于到来了
人工智能智能体来到了我们中间。对那些多年把复杂想法装在脑子里的研究者来说,这是一场真正的拯救。
因为现在,在你身边的不只是一个执行命令的工具。还有一些帮手,它们能实现假设、测试各种变体、搜寻错误、提出不同的走法、与你争论、改进代码、运行实验,做一个人一辈子都没有足够时间去做的事。
我在 Arcanada 生态系统中的新产品就是这样诞生的。
它叫 Cubrim。俄文是 Кубрим。
Cubrim 是一个本地数据归档器。我在其中实现的第一件事,就是我在归档领域的那个旧想法。而且它奏效了。它确实产生了压缩的结果。
但要弄清这个结果究竟有多好,我要做的远不止写出算法。
我必须弄清楚,今天世界上是怎样比较归档器的。有哪些基准。测试数据集是怎么构建的。哪些指标被认为重要。“看起来不错”在哪里结束,与世界领先者的诚实比较从哪里开始。
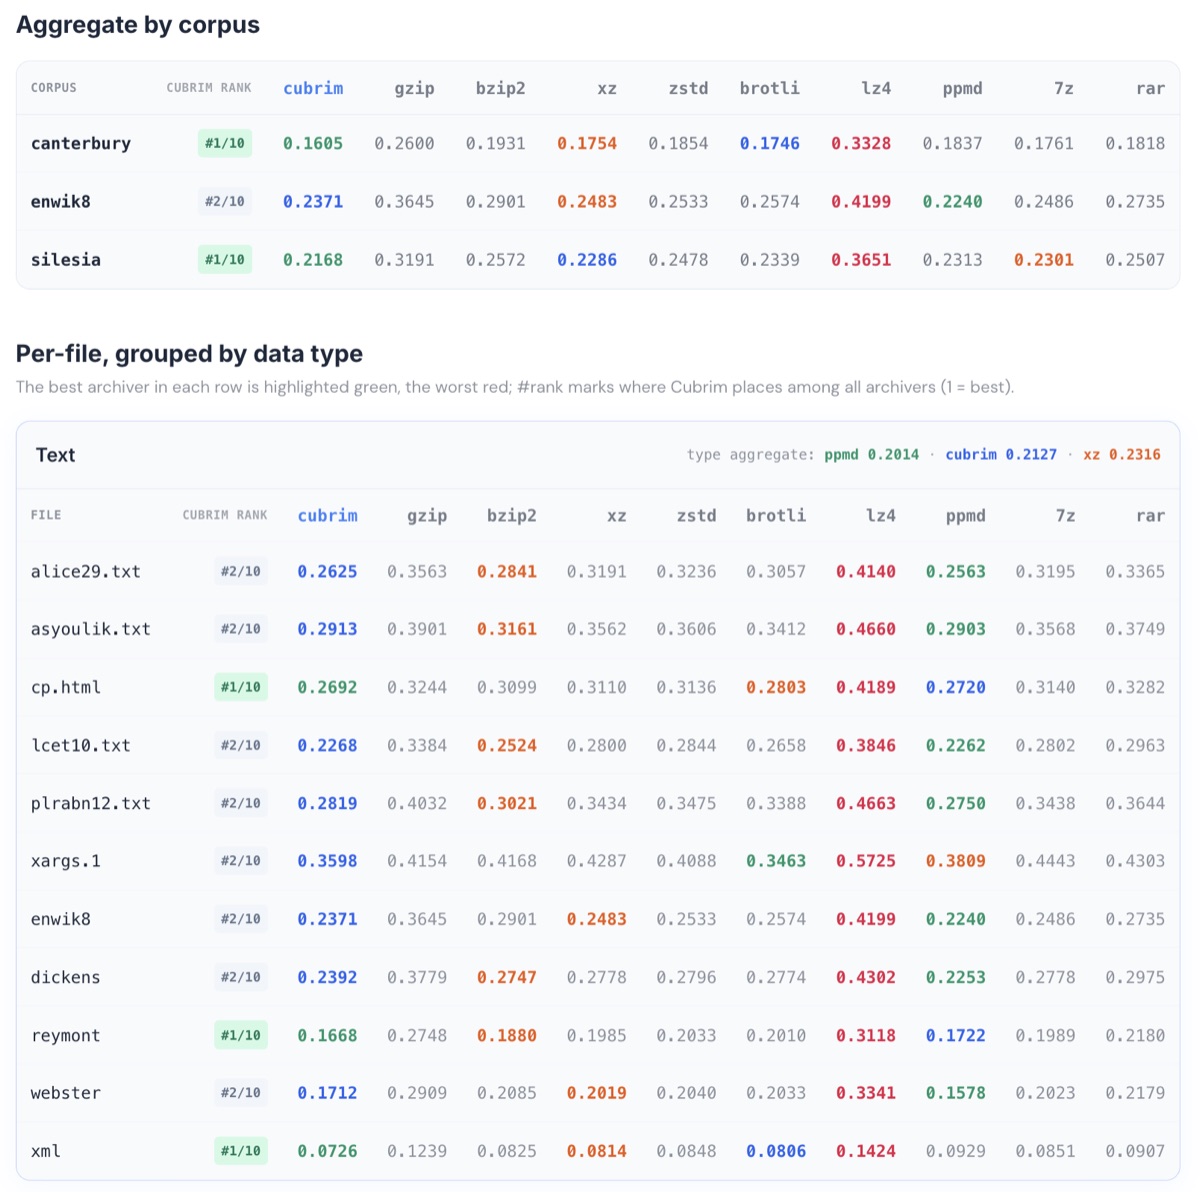
我找到了三个领先的基准作为目标。我在我那台强大的专用服务器上复现了它们,并开始在这些数据上运行 Cubrim。
真正的研究工作
真正的研究工作就从这里开始了。
我优化了算法。我改变了存储展开矩阵的方法。我重新考虑了数据分析。我寻找新的处理方式。我一个接一个地检验假设。
名次逐渐开始提升。
起初 Cubrim 排第十。然后第九。然后第八。然后第七。
一步一步,它开始追赶并超过领先者。
与此同时,几十个智能体在工作,探索我的假设。到现在已经有八十多个这样的假设。其中大部分发布在网站上。在那里你还可以看到归档器开发的全部进展、实验的结果,以及 Cubrim 在世界基准上的移动。
而今天,那个奇迹真的发生了
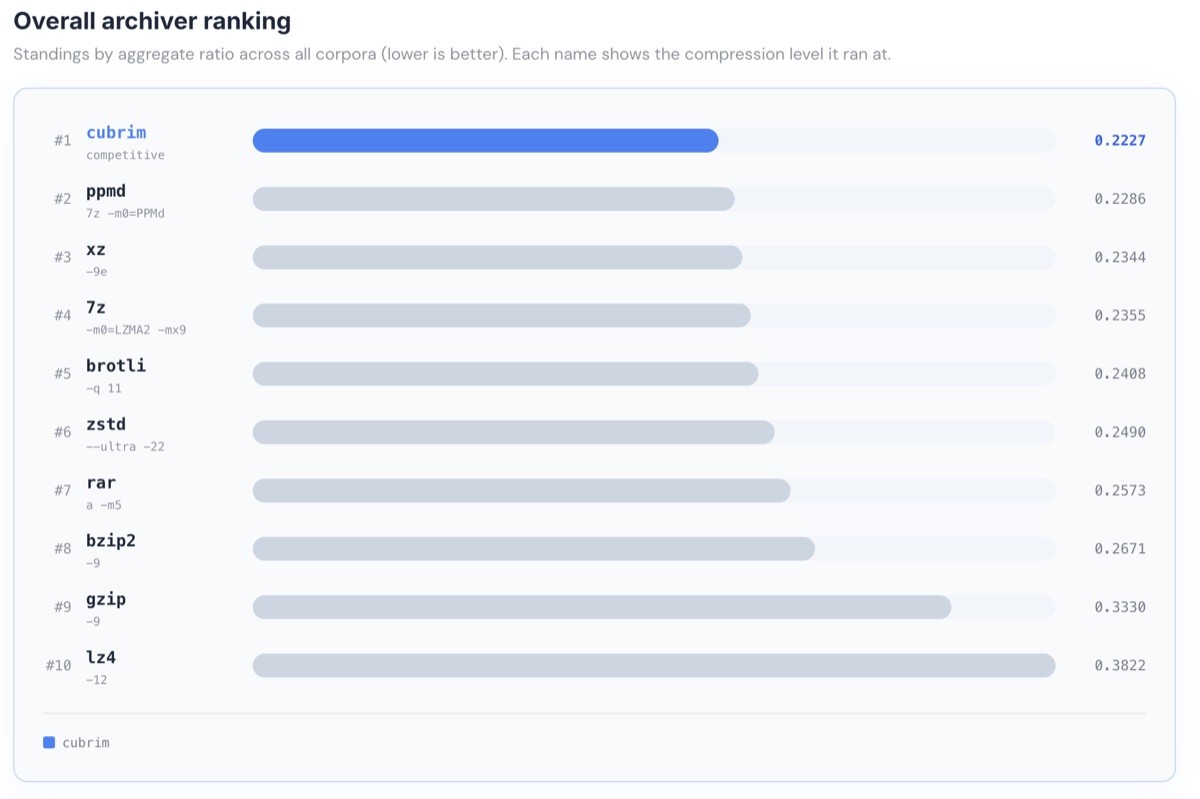
积累下来、需要很长时间来计算的那些假设,终于算完了。一份最新的基准排名发布了。
结果发现,Cubrim 已经在几项关键的比较中占据前列。在一个基准中它拿到第一。在另外几个中是第二。而在大多数单独的数据类型上,Cubrim 都位列第一或第二。
对我来说,这是一个非常有力量的时刻。
当然,前面还有很多工作。我看得到结果还可以在哪里改进。我想在每一项有意义的指标上都拿到第一。我想让这个归档器不仅强大,而且快速、稳定、方便、达到工业级。
但即使是当前的结果,也已经意义重大。
因为它向我证明了一件简单的事:人工智能智能体的用处,不只是迅速拼出又一个 MVP 或概念验证。
借助它们,你可以实现旧日的梦想。
那些多年躺在你的脑子里、笔记本里、旧文件里、未完成项目里的想法。那些曾经对一个人来说显得太复杂的研究方向。那些需要一个团队、预算、时间、服务器、耐心和几十次尝试的任务。
现在,这正变得可能。
Cubrim 对我到底为什么重要
我需要为 Arcanada 准备自己的数据载体。生态系统内部的数据会非常多。它们将分布式存放,分布在不同的服务器上、不同的环境里、以不同的格式。我需要一个属于这个生态系统的归档器。理想情况下——快速、强大、独立。
我开始做 Cubrim 时,并没有“打败所有人”的想法。对我来说,能创造出我自己的、确实能压缩数据、而且不必为别人的许可证付费的算法,就足够了。
Cubrim 对个人用户将是免费的。不久我计划把它放到网站上供下载。商业使用将有单独的许可证——大约每个工作站每年 30–50 美元。
但此刻,就连这也不是主要目标。
Cubrim 的主要想法要宽广得多
我在学生时代想到的那个想法,涉及的不只是一个本地归档器。它涉及全局数据压缩、全局数据寻址,以及跨越巨大距离传输海量信息。
包括——跨越宇宙尺度的距离。
或者在无线电通信极其糟糕的条件下。
我们正与我的女儿 Ekaterina 一起开发这个项目。她是航空航天工程师,这对我来说尤其珍贵。因为 Cubrim 正逐渐变成不只是一个归档器,而是一个关于数据存储、传输和寻址之未来的研究项目。
这个系列的第二篇文章将专门谈这个主题。
在其中,我将讲述全局寻址器(Global Addresser)和 Valentov 通用数据表(Valentov Universal Data Tables)——讲述 Cubrim 中那部分:它不再只是文件压缩,而成为一种尝试,用新的眼光看待在一个距离、通信信道和信息量都变成关键约束的世界里的数据传输。
第三篇文章将谈更偏应用的一面:Cubrim 的算法、归档器市场,以及这类技术在现代世界究竟如何变现。
但今天,我只想分享我的喜悦
梦想有时真的会成真。
不总是很快。不总是以我们期待的方式。有时它们需要在你脑子里躺上许多年,等待合适的时机、合适的工具、合适的人,以及合适的痛。
但如果一个想法是活的——它会回来。
而今天,对我来说,Cubrim 正是这样一次回归。
感谢你关注我的消息。