
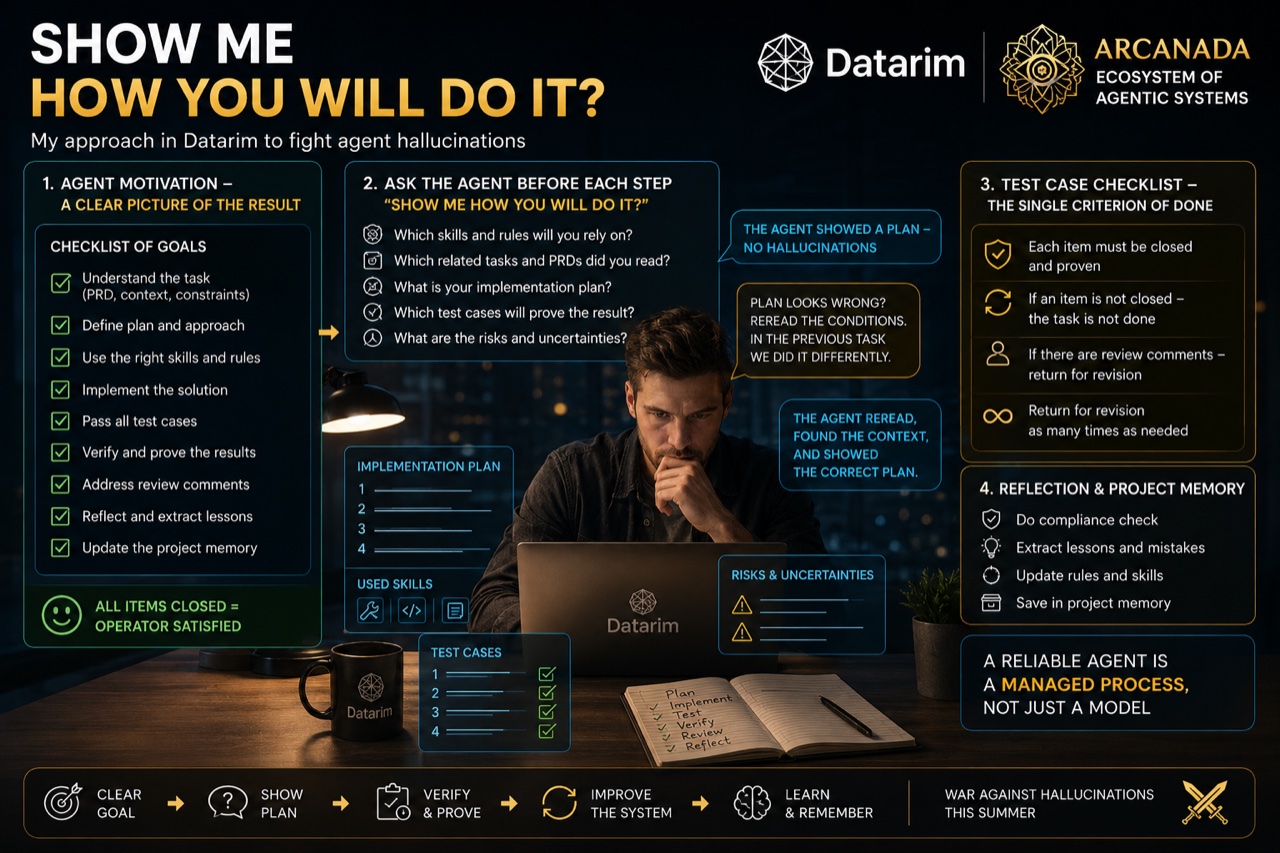
今年夏天,我的整个生活都在一面非常具体的旗帜下运行:与智能体幻觉的战争。
不是抽象意义上的“模型有时会撒谎”。这一点人人都知道。而是实践的、工程意义上的:怎样才能让一个智能体系统可靠地完成一项任务,而不陷入幻想、不忘记规则、不无视 PRD、不过早关闭任务,也不假装工作已经做完?
在 Arcanada 智能体系统生态里的 Datarim 中,我反复回到一个简单的想法:智能体需要动力。
这听起来很奇怪。智能体没有个性,没有情感,没有野心,没有人想把事情做好的愿望。但我所说的“动力”是另一回事:需要非常清楚地告诉智能体,对它的期待是什么。
不只是“完成这项任务”。不只是“实现这个功能”。不只是“修复这个 bug”。
而是给它描绘一幅关于结果的清晰图景。
这件事应该产出什么。哪些事项必须关闭。正确的解决方案是什么样子。哪些测试用例必须通过。操作员、评审智能体或系统会凭哪些迹象认定工作确实完成。
这样做的最佳方式不是抽象的文字,而是检查清单。因为检查清单把期待变成契约。
如果每一项都关闭了,任务才算完成。只要有一项没有关闭,任务就没有完成。如果某一项只是“纸面上”关闭、却没有证据,任务就没有完成。如果评审智能体提出了意见,任务就退回修改。而且要退回多少次,就退回多少次。
哪怕这个循环看起来没有尽头。因为另一种选择更糟:智能体欢快地报告一切就绪,而实际上它只是丢掉了一部分条件,编造了缺失的细节,并在自己的脑子里把任务关掉了。
给智能体的关键问题
我现在在每个实现步骤之前都会问智能体的最简单也最有用的问题:
“你打算怎么做,给我看看?”
看起来很平常。智能体只是去列出一份计划。写下它要看哪些文件,依靠哪些规则和技能,重读哪些相关任务,运行哪些测试,会考虑哪些约束。
但恰恰在这一刻,发生了重要的事:智能体不再幻想,开始定位自己。
它重读 PRD。调出以前类似的任务。查看项目规则。把当前任务与现有的解决方案对照。然后才开始行动。
缺了这一步,模型就太容易开始产生幻觉。这在 Claude 的“变笨”模式下尤其明显:当上下文已经塞得很满、据我的经验窗口超过 20% 时,当任务很长、计划有很多条目时,当模型开始节省注意力或滑入较弱的推理模式时。
有时看起来就像是换了某个更弱的模型在解决任务,而不是正常的 Claude。一个想象中的 Haiku,似乎在努力,却已无法把握全局。
有意思的是:只要面前有一幅清晰的结果图景,并且强迫它把计划说出来,即使是较弱的模型也会明显工作得更好。不是单纯的“去做”,而是先说:“你打算怎么做,给我看看。”
为什么这能减少幻觉
智能体的幻觉往往不是从它写代码的地方开始的。它开始得更早——在它误解了任务、却没有向操作员表现出来的那一刻。
它没有重读 PRD。没有检查旧的实现。没有找到相关的模式。没有对照项目规则核实。没有弄清哪些测试用例是必须的。但它已经开始行动了。
在普通的开发中,人也会犯同样的错误。但人至少有时会停下来问:“等一下,我们真的是这样做的吗?”智能体靠自己往往不会停。得教它停下来。
所以“你打算怎么做,给我看看”这个问题,起的是行动前强制暂停的作用。这不只是规划。这是对理解的检查。
如果智能体给出了错误的计划,我立刻就能看到问题,并说:“再把条件读一遍。上一个任务我们不是这样做的。”
然后有用的“魔法”就起作用了:智能体回到上下文,找到旧任务,重读规则,常常自己给出正确的计划。也就是说,错误是在实现之前被发现的,而不是在代码坏掉之后。
检查清单比“觉得已经做完”更重要
在 Datarim 中,我越来越多地把这条原则固化下来:在测试用例的检查清单关闭之前,任务不算完成。而且关闭不是“凭感觉”,而是附有证据。
对于每一项,都必须清楚:
- 究竟检查了什么;
- 在哪里检查的;
- 凭什么结果来确认;
- 还有什么仍有争议或未经验证;
- 评审智能体是否有意见。
如果某一项没有关闭,任务退回。如果没有证据,任务退回。如果评审智能体发现了问题,任务退回。如果智能体“认为”一切就绪,却说不出为什么,任务退回。
是的,这可能造成很长的循环。是的,有时令人恼火。是的,有时感觉像智能体卡住了。但这仍然比自信地产出垃圾的自动化要好。
没有验证的自主性不是自主性。它是技术债的生成器。
最后阶段的问题
还有一个重要的点。智能体在关闭或归档任务之前,常常忘记做反思。
即使自我学习的技能已经写好。即使规则图已被重写了一百遍。即使系统明确规定,任务结束后必须提取教训并存入项目记忆。智能体仍然可能跳过这一步。
所以我得手动提醒它:
“做一次合规检查,并展示提取出的、需要放进项目记忆的教训和错误。”
这是斗争中单独的一部分。因为一个智能体系统不应该仅仅完成任务。它在完成任务之后应当变得更好一点。
如果智能体犯了错——它应该进入记忆。如果智能体发现了新的模式——它应该进入规则。如果 PRD 含糊不清——应该被记录下来。如果某个测试用例被证明很重要——它应该成为今后检查的一部分。如果评审智能体抓到了一个典型的问题——它应该强化下一个循环。
否则我们就不是在构建一个系统。我们只是每一次都在和一个健忘的承包商说话。
我现在在 Datarim 里改了什么
现在,我正在教编排器自动运行这些复核。
在任务的每个阶段之前,智能体必须展示:
- 它是怎样理解这项任务的。
- 它依靠哪些 PRD、规则、技能和以前的任务。
- 它提出什么样的实现计划。
- 哪些测试用例将证明任务完成。
- 它看到哪些风险和含糊之处。
阶段之后,它必须展示:
- 究竟做了什么。
- 检查清单的哪些项已经关闭。
- 凭什么来证明。
- 有什么还没有验证。
- 评审智能体有什么意见。
- 哪些教训需要存入项目记忆。
这把智能体从一个“行动的生成器”,变成了受管理流程的参与者。它不再只是做点什么。它必须解释为什么这样做。证明它做了。并把新的经验交给系统。
与幻觉的战争
智能体的幻觉无法靠一条神奇的指令击败。你不能只在系统提示里写一句“不要产生幻觉”。那没用。
你需要架构。你需要 PRD。你需要检查清单。你需要测试用例。你需要评审智能体。你需要返工的循环。你需要项目记忆。你需要完成之后的反思。并且在工作开始之前,你需要一个简单的、人性的问题:
“你打算怎么做,给我看看?”
这个问题看起来很小。但它改变了智能体的工作方式。它迫使模型停下来。重读条件。找到自己的锚点。组装一份计划。在假设变成代码之前,把它们摆出来。
而这恰恰是混乱的智能体自动化与真正的工程系统之间的分界线。
对我来说,Arcanada 不是让智能体随便“做点什么”。它是一个生态系统,智能体在其中工作、相互检查、从错误中学习,并逐渐变得更可靠。Datarim 就是这个生态系统的工具之一。
而我今年夏天的主要战斗,就是确保智能体不只是完成任务,而且每一次都能诚实地回答:
“这是我的理解。这是我打算怎么做。这是我依靠的东西。这是我将如何证明任务完成。”
在智能体能展示这些之前——把自主权托付给它还为时过早。