
昨天我看到了一篇关于 MCP 与 CLI 的 Reddit 帖子。
作者提出了一个在 AI 智能体开发者中越来越常被问到的问题:如果普通的 CLI 在许多任务上更便宜、更快、更可靠,我们真的还需要 MCP 吗?
这个话题与我在 Arcanada 里做的事直接重合:自主智能体的架构、意义管理技术,以及知识契约(Knowledge Contract)的想法。
我越是细看评论区里的争论,就越觉得“MCP 还是 CLI”也许根本就是个错误的问题。两派在重要的方面都是对的;只是讨论发生在比问题最终应当被解决的层次低一层的地方。
先从争论本身说起。
“CLI 比 MCP 好”从何而来
帖子作者引用了 Scalekit 的基准测试:75 次测试运行,比较 AI 智能体通过 MCP 和通过 CLI 工作的表现。
结果对 MCP 相当严酷。
按任务不同,CLI 所需的 token 少几倍,有时少几十倍。
最简单的例子很能说明问题:判断一个仓库的语言,通过 CLI 需要 1,365 个 token,通过 MCP 需要 44,026 个。
在 Scalekit 另一项每种方式运行 25 次的可靠性检验中,CLI 完成了 25 次中的 25 次(100%),MCP 完成了 25 次中的 18 次(72%)。
这就引出了一个完全合理的问题:
我们为什么要建成千上万个 MCP 服务器?
我们是不是又在重复那种常见的模式:整个行业仅仅因为新标准时髦就一拥而上?
讨论中有一条评论说得很清楚:
MCP 是做工具的人喜欢的。CLI 是用工具的人喜欢的。
这相当准确。
为什么 CLI 如此适合智能体
在拆解双方的论据时,要记住:CLI 不只是调用函数的又一种接口。
直接调用工具时,智能体立即得到工具的响应。CLI 则在模型与结果之间插入了一个 shell 和可编程的数据处理。
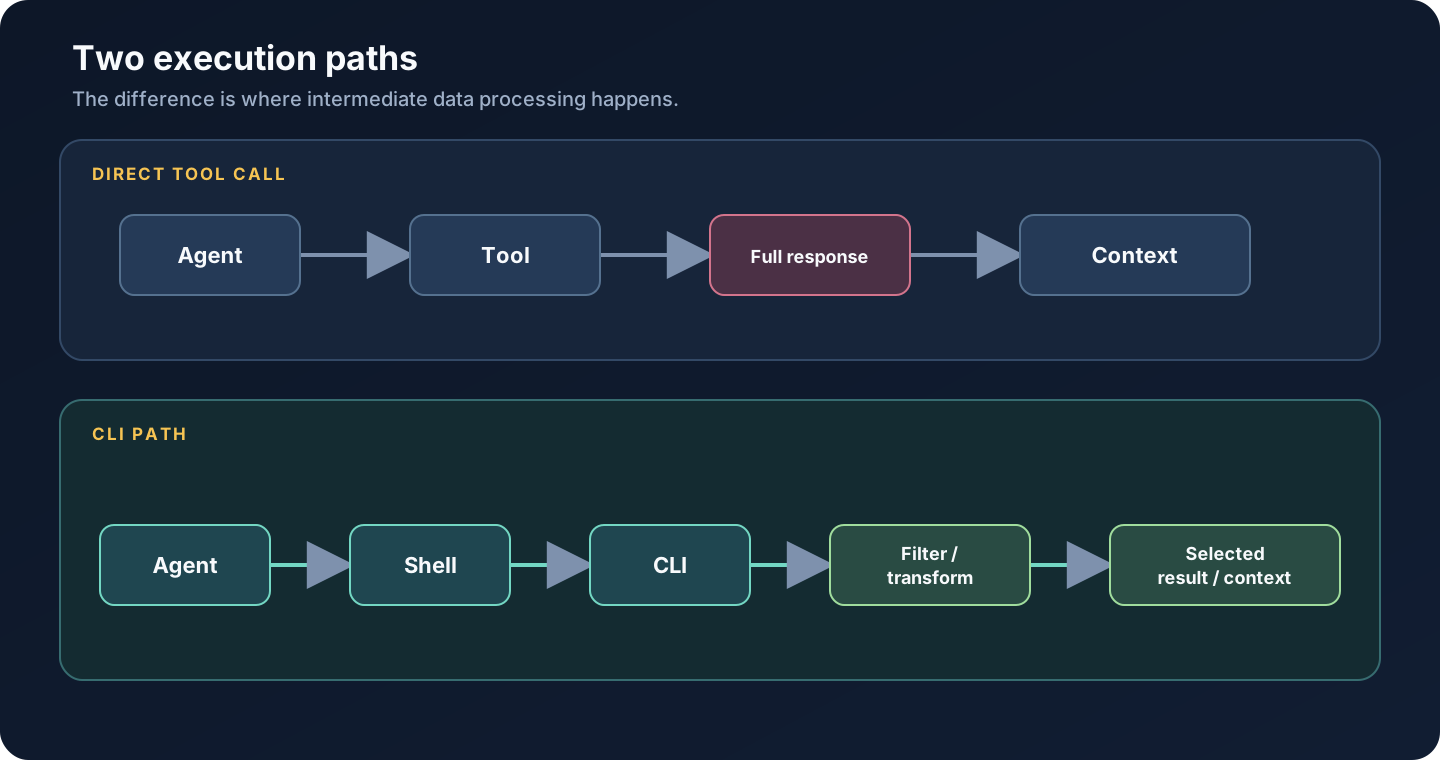
上方路径表示直接调用工具并得到完整响应。下方路径中,智能体启动 shell,CLI 取得数据,中间程序对其过滤,只有被选出的结果进入上下文。
模型与工具之间出现了一个可编程的计算环境。
这让系统能在响应到达模型的上下文之前就把它缩小。
假设智能体请求几兆字节的日志。
如果普通工具把这一切都返回到上下文里,模型就得想办法读完并处理一个巨大的响应。
通过 CLI,智能体可以这样做:
deployment list --json \
| jq '.[] | select(.status == "failed") | {id, reason}' \
> /tmp/failed.json
然后只读结果。
它可以使用:
- grep
- jq
- awk
- sed
- sort
- head
- SQL
- Python
- 管道
- 文件
所以 AI 不只是在调用一个工具。
它是在为信息的中间处理编程。
在我看来,这就是编码智能体在终端里如此自在的原因之一。
帖子下面有一条不错的评论:
CLI 让智能体更有能力。
这句话乍听之下有点夸张。
但仔细想想,是说得通的。
CLI 给智能体的不是一份函数目录。
它给智能体的是一台小型计算机。
但 MCP 也有很有力的论据
现在设想另一种情形。
你的 AI 智能体不是运行在你的服务器上,也不是在处理你的 Git。
它是在代表成千上万的客户行事。
它连接到:
- GitHub
- Gmail
- Slack
- Salesforce
- 企业数据库
- 内部 SaaS 系统
这就带来一组完全不同的问题。
智能体此刻是以哪个用户的身份在行事?
该用户有哪些权限?
他们属于哪个组织?
应该使用哪些凭据?
智能体只允许读取信息,还是也能修改?
如何撤销访问权限?
事后如何确定是谁执行了某个操作、为什么执行?
当智能体代表其他用户行事时,仅仅给它一个 shell,会与身份认证、授权、租户隔离和审计要求相冲突。
讨论中有一条评论把这条边界描述得很好:
CLI 非常适合个人工具和内部自动化。
但当智能体代表其他用户行事时,就会出现身份认证、授权、租户隔离和审计。
而在那里,MCP 确实解决了另一个问题。
那么,两派都对吗?
在很大程度上,是的。
CLI 是很好的执行机制。
MCP 是很好的集成机制。
这就是我喜欢另一条评论的原因:
我们两者都用。核心产品是完整的 CLI;远程访问和 A2A 会话使用 MCP。
这与我现在在 Arcanada 里设计的东西近得多。
就连“CLI 还是 MCP?”这个选择,对智能体本身来说也太低层了。
智能体为什么要考虑这个?
这与我过去几个月一直在做的主题相关。
现代 AI 智能体的一个问题是,我们一直把系统几乎全部的复杂性压在模型身上。
模型收到一项任务、一段提示、RAG、150 个工具、20 个 MCP 服务器、权限、文档和额外规则,然后得自己弄清楚基础设施。
接着,当上下文增长到几十万个 token、智能体开始糊涂时,我们又感到惊讶。
我越来越相信相反的模型:
系统在智能体启动之前能确定的事情越多,智能体自己需要看到的基础设施复杂性就越少。
我在 Arcanada 里做的一个想法就由此而来:知识契约(Knowledge Contract)。
什么是知识契约?
我不打算在这里公开全部结构;它将是另一篇文章的主题。
基本结构是这样的。
智能体不应该只收到:
“这里有一项任务,自己想办法。”
执行之前,任务要先经过一条单独的解析器流水线(Resolver Pipeline)。
系统会尝试判断,智能体为完成这一项具体的工作需要哪些意义。
结果是一份结构化的知识契约。
在当前的模型中,它包括:
任务(Task)、角色(Role)、技能(Skills)、蓝图(Blueprints)、约束(Constraints)和成功标准(Success Criteria)。
例如,设任务为:
查明生产环境部署为何失败,并准备修复。
系统可能判定:
角色:软件工程师(Software Engineer)
- 技能:调试、部署分析、测试
- 蓝图:生产事故调查;安全的代码修改;制作者—检查者校验
- 约束:生产环境只读;获批后才能部署
- 成功标准:找到根因;准备好修复;测试通过
因此智能体收到的不只是一段提示。
它收到的是关于这项任务的意义与执行的一份契约。
这与我更广泛的任务——管理意义——相连。
我们不是单纯想把更多信息塞进上下文。
我们是想判定:
要解决这项具体任务,需要哪些信息、角色、技能、行为模式和约束。
Reddit 提示了另一个要素
在拆解 MCP 与 CLI 之争时,我意识到知识契约大概还需要一个基本维度。
能力(Capabilities)。
也就是智能体完成任务所需要的能力。
对我们的例子来说,它可能是这样:
能力:repository.read、repository.diff、logs.query、deployment.status、tests.run
知识契约列出能力,但不规定它们通过 MCP 还是 CLI 提供。这由能力解析器(Capability Resolver)来决定。
能力是“做什么”,执行机制是“怎么做”
假设智能体需要能力 repository.diff。智能体不应自己选择协议:能力解析器会在能力、其执行者和其访问机制之间建立绑定。
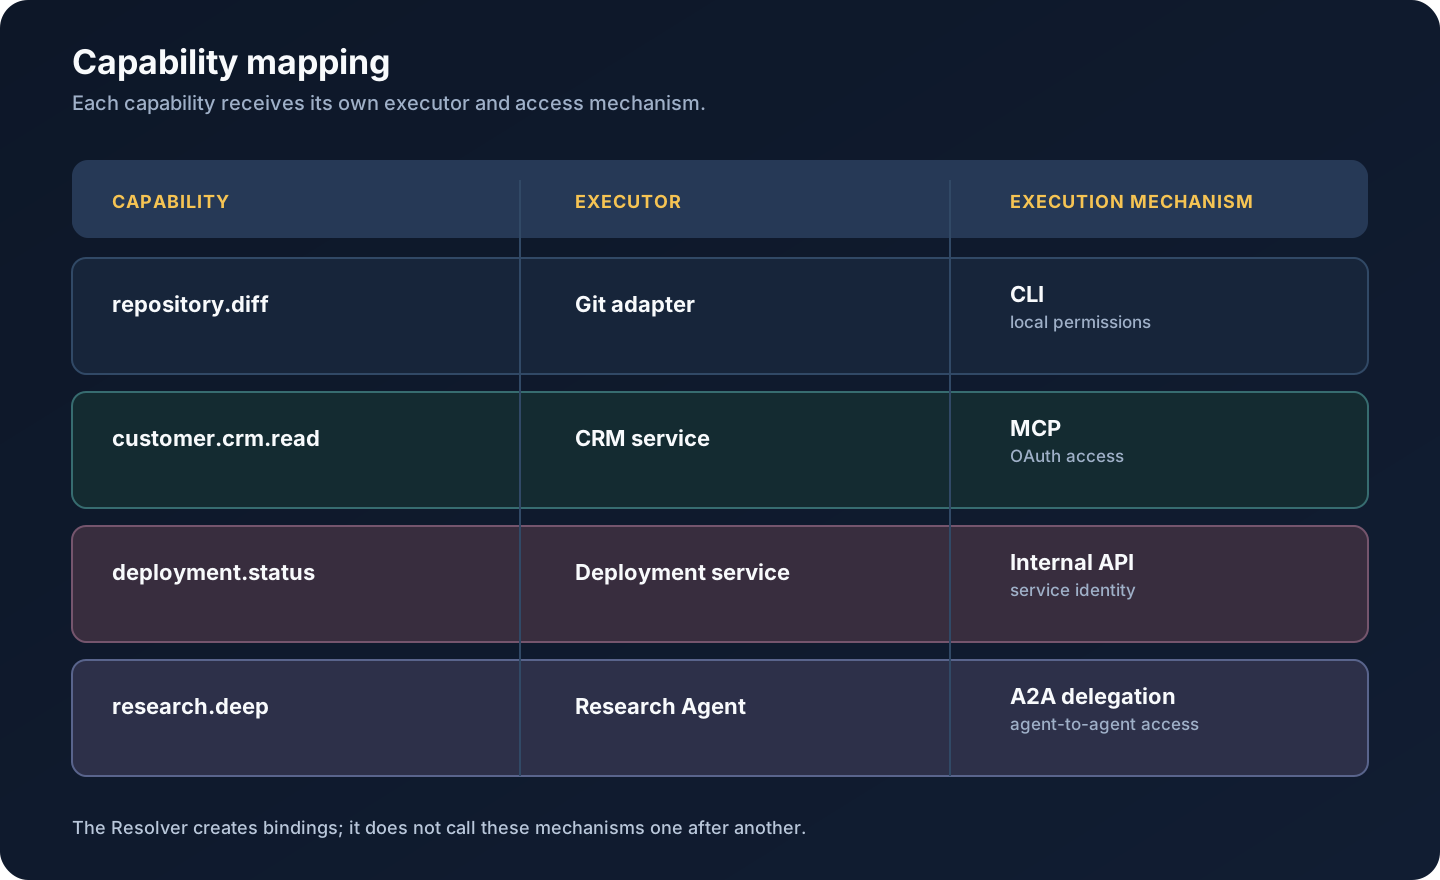
每一行都是独立的映射,而不是一连串调用。OAuth 定义对 MCP 服务的访问,研究智能体仍是执行者,A2A 负责智能体之间的委派。
在推理层面,智能体处理的是所需的能力:
repository.diffcustomer.crm.readdeployment.statusresearch.deep
它不需要知道系统是通过 CLI、MCP、API 还是另一个智能体来提供它们。
这就是我认为正确的抽象边界。
智能体应当用行动思考,而不是用协议思考
想想一个人。
当程序员想到:
我需要查看仓库里的变更,
他不会在 Linux 内核系统调用的层面上推理。
我们打开文件时,不会去想 SSD 的扇区。
我们运行 SQL 查询时,不会去想 B 树的页。
好的架构不断创造这样的边界。
为什么我们突然认定 AI 智能体应当理解整个基础设施?
我认为智能体应当这样想:
我需要拿到部署日志。
而不是:
现在我得找到第 17 号 MCP 服务器,选出第 43 号工具,研究它的 JSON Schema,并构造正确的载荷。
也不是:
现在我得记住某个厂商的确切 CLI 命令。
那是基础设施。
不是推理。
能力解析器
Arcanada 的架构使用能力解析器,把一项任务及其知识契约连接到具体的执行计划。
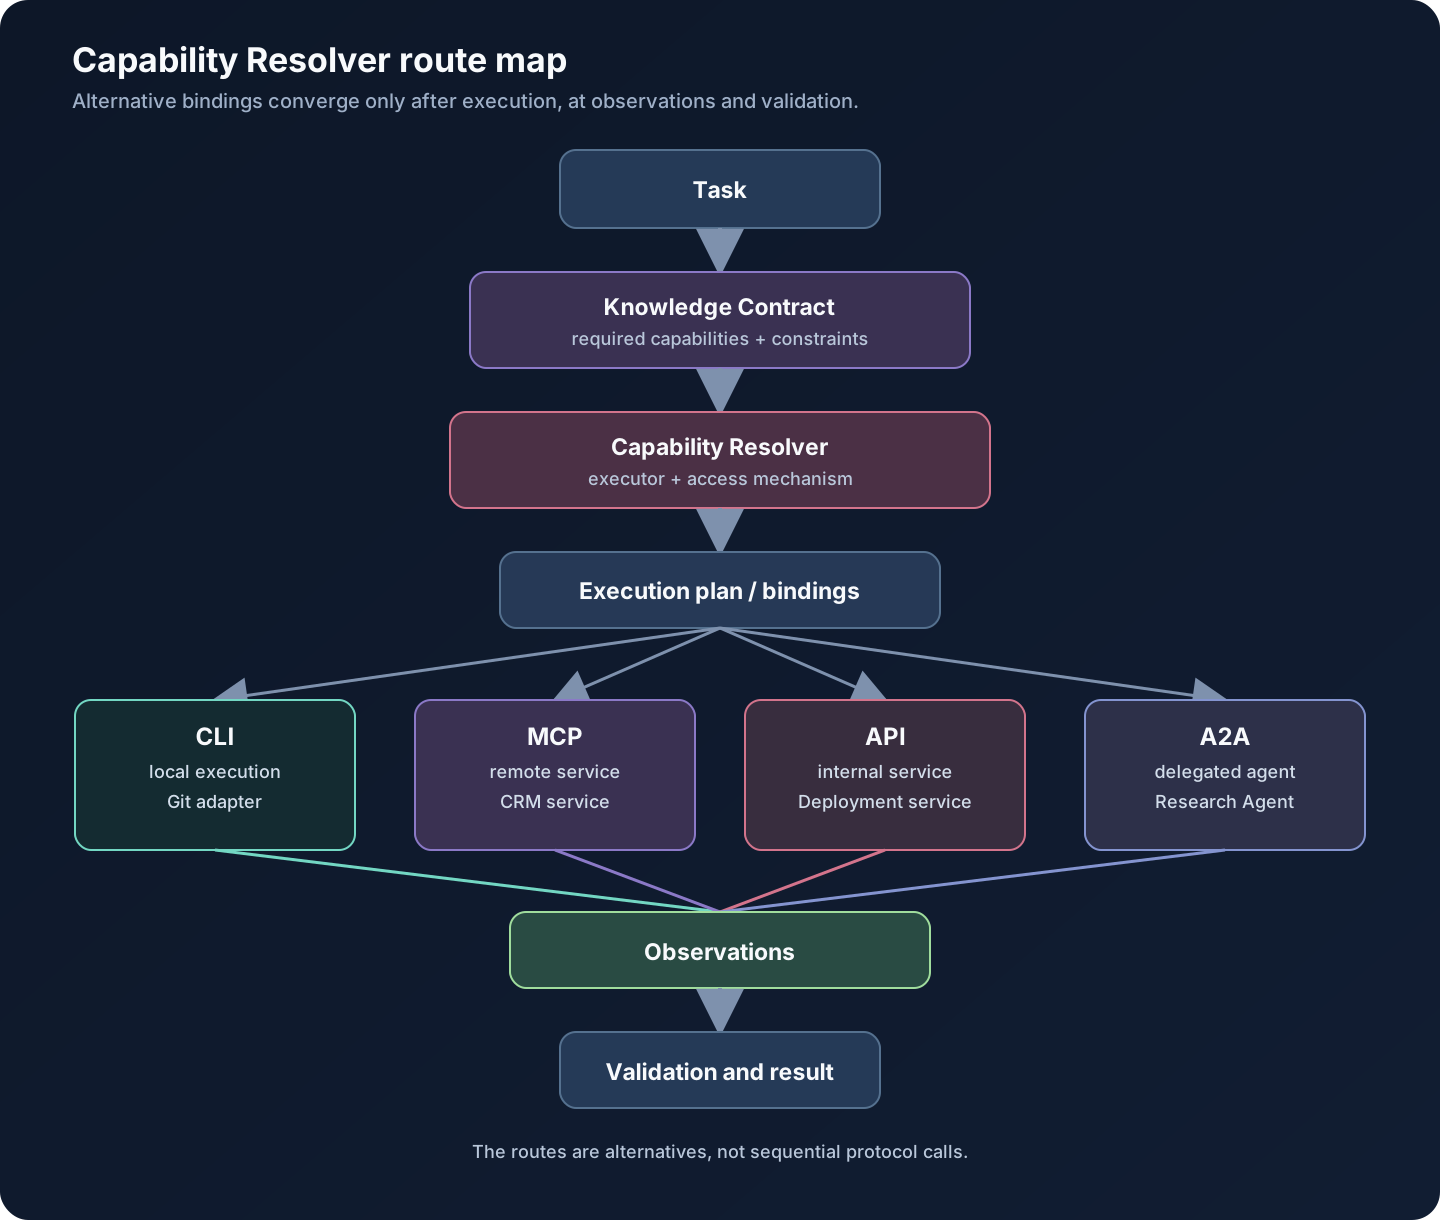
知识契约记录智能体需要知道什么、做什么。解析器决定由谁来执行每种能力、通过哪种机制、带着哪些权限。这些路线是可替换的绑定,只有在产生观察结果之后才汇合。
如果一项任务需要三种能力,智能体不需要知道系统里还有另外三百个工具。
它只会收到 repository.diff、logs.query 和 tests.run。
这不再只是节省 token
上下文窗口的成本只是问题的一个方面。
后果不止于上下文窗口的成本。
智能体拿到的能力面越小,以下各项就越少:
- token 成本;
- 选错工具的可能;
- 可能出现的错误数量;
- 攻击面;
- 权限集合;
- 推理的复杂度。
因此,能力解析器同时成为:
上下文优化器、执行路由器,以及安全架构的一部分。
因此解析器缩小能力面、为执行选路,并参与安全架构。
还有第三条路:Code Mode
Reddit 评论里有一个支持 CLI 的有力论点:
CLI 让你把大量输出发到文件里,过滤它,用其他程序处理,之后才展示给模型。
传统的工具调用在这方面差得多。
还有另一种方式:Code Mode。智能体不再在模型与工具之间进行多次连续的往返,而是在一个程序里完成中间处理:
const deployments = await deployment.list();
const failed = deployments
  .filter(x => x.status === "failed")
  .map(x => ({
    id: x.id,
    reason: x.failureReason,
  }));
return failed;
它在沙箱中运行。
模型只收到结果。
Code Mode 保留了 CLI 的主要优势——可编程的中间计算——并把它与某个具体的 shell 界面分开。这就是我认为代码执行运行时(Code Execution Runtime)是 Arcanada 这一层一部分的原因。
有时能力根本不是工具
能力也可能意味着把工作委派给另一个智能体。
假设智能体明白:
我需要对这个假设做深入研究。
它为什么非得调用工具?
例如,能力 research.deep 可能意味着通过 A2A 把工作委派给研究智能体。A2A 不是执行者;它把工作交给另一个自主的执行者。
CLI、MCP、API 和 A2A 不必相互竞争。它们支持执行能力的不同方式。
智能体应当在哪个层次上运作?
有一段时间以来,我一直试图比传统的讨论再上一层:
模型 + 提示 + 工具
我不满意这样的做法:智能体设计从选择运行框架(harness)或罗列工具开始。
首先,我们要确定任务的意义,以及执行它所需的条件。
之后,系统再选择智能体模型、技能、知识、工具和执行机制。这就是我研究知识契约的原因:MCP 与 CLI 之争清楚地说明了为什么需要这一层。
系统先确定所需的能力,再选择如何提供它。这种区分对我很重要。
Arcanada 现在正在设计的东西
在 Arcanada 以及与之相关的项目里,我目前正在设计并逐步实现类似这样的东西:
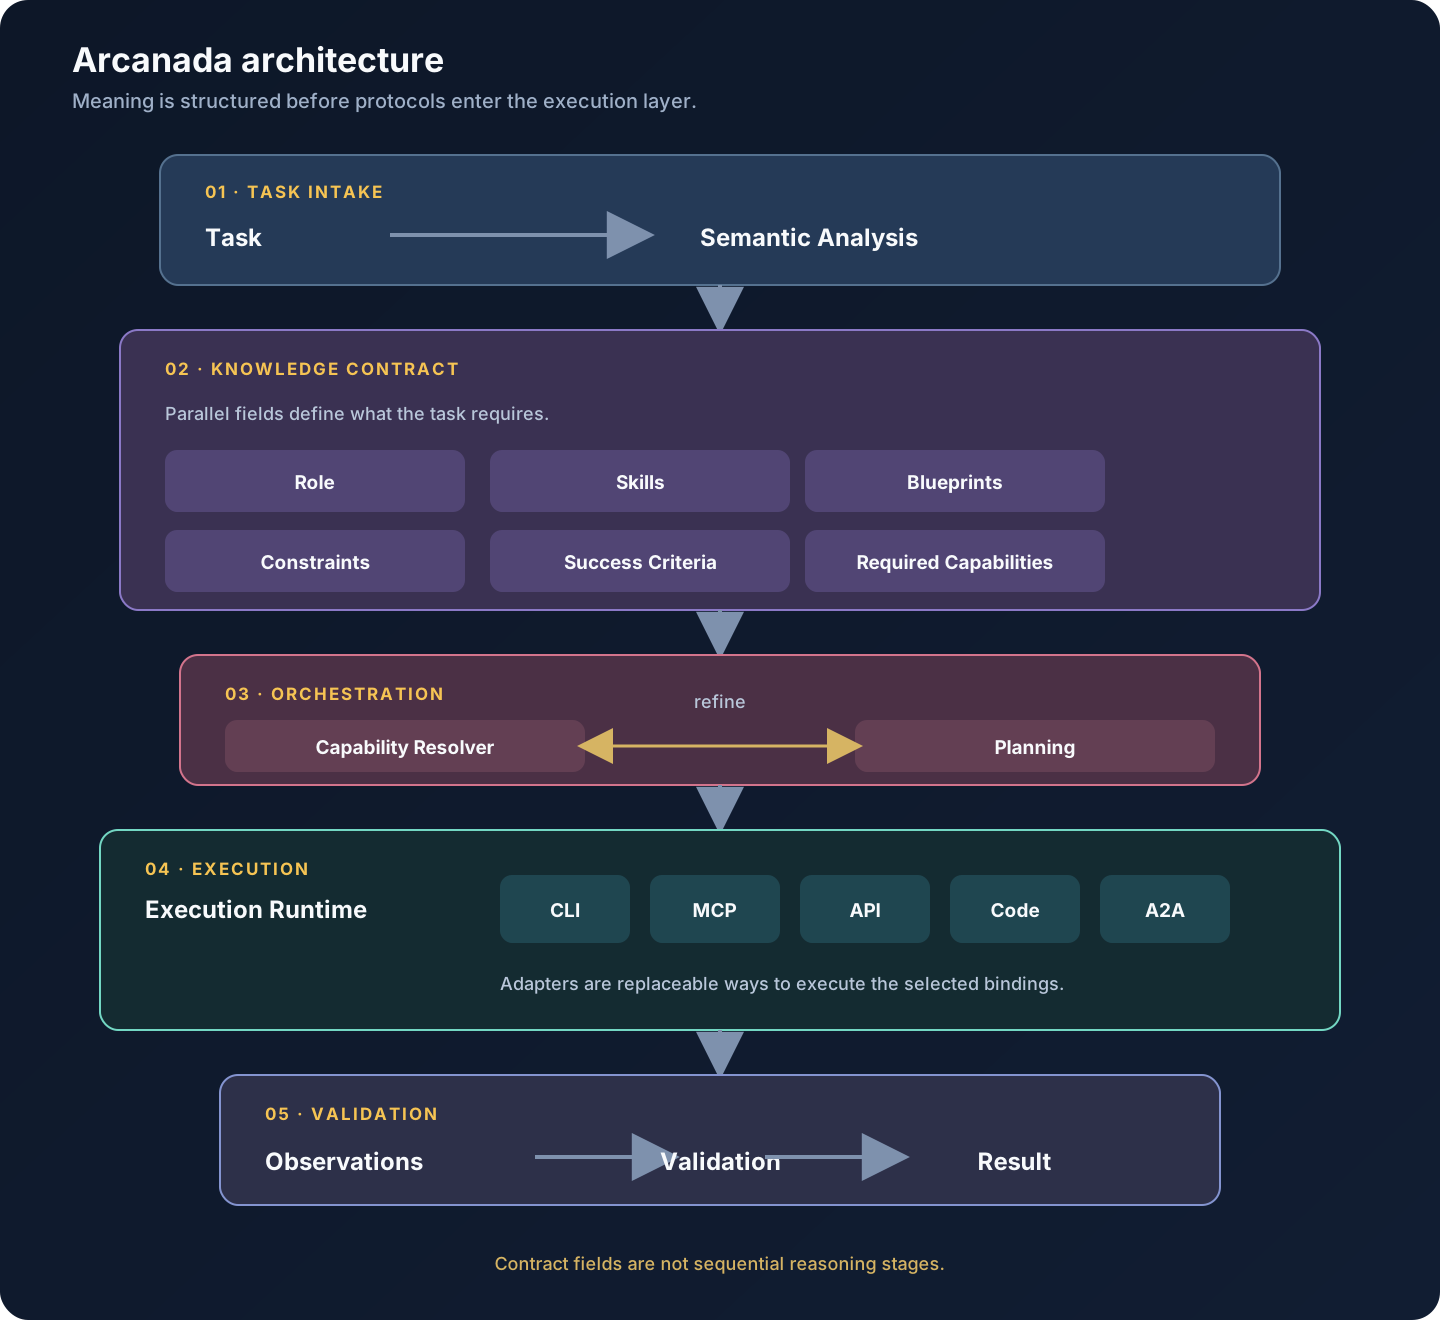
该图把系统分为五层。任务接收负责表述任务并做语义分析。知识契约保存并列的字段:角色、技能、蓝图、约束、成功标准和所需能力。接着编排把能力解析器与规划连接起来。
在执行层,运行时可以使用 CLI、MCP、API、代码或 A2A 适配器。执行之后,系统把观察结果送去校验,并产出结果。
这一架构的不同部分分布在 Arcanada 的几个组件中。
- 任务及其状态与生命周期被单独管理。
- 知识和蓝图被单独存放。
- 上下文的选择是单独的一层。
- 执行与结果控制被分开。
我不想造一个巨大的“聪明智能体”。
我是在尽可能把复杂性从智能体的脑子里搬出来,放进它周围的架构中。
那么,到底是 MCP 还是 CLI?
读完 Reddit 的讨论,我的回答是:
CLI 是极好的执行机制。
MCP 是标准化集成层的极好候选。
API 和 SDK 不会消失。
Code Mode 可能成为组合操作的最佳方式之一。
自主执行者之间的交互需要 A2A。
没有必要选出一个赢家。
在 Arcanada 里,我正走向一种混合模型:
知识契约记录能力,能力解析器选择最合适的可用执行机制(Execution Mechanism)。
今天,一种能力可能通过 CLI 运行。
明天,同一份契约可能使用 MCP。
一年后,也许会出现更好的协议——我们就换适配器。
智能体不会在意。
MCP 与 CLI 之争是个实现层面的争论
在实现之上的问题是:协议变化时,什么应当保持稳定?
我现在的回答是:任务的意义、知识契约,以及所需的能力。CLI、MCP、API、Code Mode 和 A2A 是把这种意义变成行动的方式。
也许几年之后,我们就不再讨论智能体用什么协议访问某个具体工具。
就像今天的应用开发者很少会去想 SSD 控制器是怎样写入某个具体数据块的。
如果架构边界选对了,这种复杂性应当从上层消失。
这就是我正试图在 Arcanada 里建立的边界。